Logs, métriques et traces : pourquoi votre application est lente ?
Trois signaux complémentaires pour passer du constat d’un problème à la compréhension de son origine.
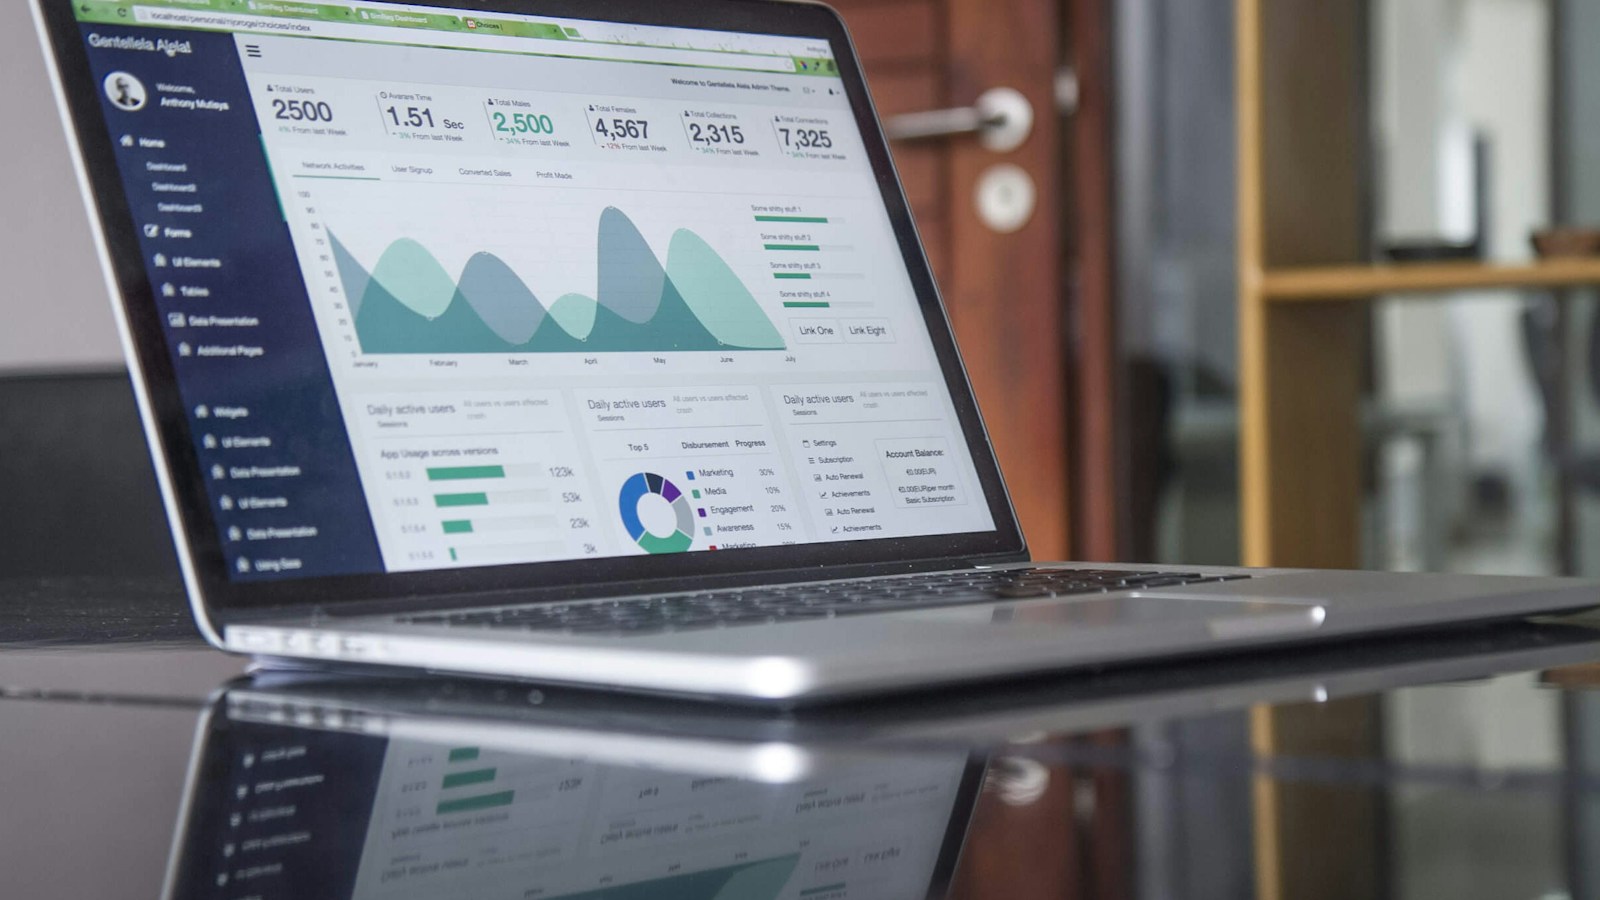
Des indicateurs à l’écran pour illustrer la supervision et la performance applicative.
Passer du constat au diagnostic
La supervision peut indiquer qu’un service répond mal. L’observabilité aide à comprendre ce qui se passe à partir de signaux émis par le système. Pour une application lente, savoir que le processeur monte ne suffit pas toujours : la cause peut être une requête de base, un service distant ou un verrou. Il faut relier les symptômes aux opérations et à leur contexte. Cette capacité se prépare avant les incidents en instrumentant les parcours importants. Ajouter des logs au hasard pendant une panne peut aider ponctuellement, mais ne remplace pas une stratégie de collecte cohérente.
Les métriques résument un comportement dans le temps
Les métriques décrivent notamment le nombre de requêtes, les erreurs, les durées et la consommation de ressources. Elles sont utiles pour repérer une évolution et déclencher une alerte. Choisissez des dimensions qui permettent l’analyse sans créer un nombre incontrôlé de séries. Mettre chaque identifiant client dans une étiquette peut rendre la collecte coûteuse et difficile à exploiter. Distinguez un compteur cumulatif d’une mesure instantanée et documentez les unités. Une durée exprimée en secondes interprétée comme des millisecondes peut produire des conclusions absurdes malgré un tableau de bord visuellement convaincant.
Lire les latences sans se laisser tromper par les moyennes
Une moyenne basse peut masquer une minorité de requêtes très lentes. Les percentiles aident à comprendre ce que vivent différentes proportions d’utilisateurs, mais doivent être interprétés avec le volume et la fenêtre de mesure. Comparez des parcours équivalents : une exportation longue n’a pas le même objectif qu’une ouverture de fiche. Regardez la distribution des durées, les erreurs et les dépendances. Définissez les attentes de service à partir de l’usage réel. Une optimisation qui améliore le meilleur cas mais aggrave les requêtes déjà lentes peut dégrader l’expérience malgré une moyenne plus favorable.
Les logs structurés racontent les événements
Un log structuré contient des champs exploitables, comme identifiant de requête, opération, résultat et type d’erreur. Il doit aider à reconstituer ce qui s’est passé sans obliger à lire des milliers de phrases différentes. Utilisez des niveaux cohérents et évitez de journaliser chaque détail au niveau le plus élevé. Les mots de passe, jetons et contenus clients complets ne doivent pas être copiés par défaut. Définissez accès et conservation. Les journaux sont des données d’exploitation qui peuvent devenir sensibles ; leur utilité ne dispense pas d’en limiter le contenu et la diffusion.
Les traces relient les étapes d’une même requête
Une trace suit un parcours à travers plusieurs opérations. Chaque span représente une partie mesurée, comme un appel API ou une requête de base. Les relations entre spans montrent les séquences et les appels imbriqués. La propagation du contexte permet de relier les étapes quand la requête traverse plusieurs services. Sans cette continuité, on obtient des fragments difficiles à rapprocher. Les traces sont particulièrement utiles lorsque l’application attend une dépendance externe. Elles ne prouvent pas automatiquement une cause métier, mais permettent de localiser où le temps est consommé et quelles erreurs ont été observées.
Exemple : un paiement qui devient lent
Le tableau de bord signale une hausse du temps de validation des commandes. Les métriques montrent que seules certaines requêtes sont touchées. Une trace révèle que l’appel au fournisseur de paiement dure beaucoup plus longtemps que les autres étapes. Les logs associés indiquent plusieurs reprises après expiration. L’équipe peut alors vérifier les délais, le comportement du fournisseur et la stratégie de nouvelle tentative. Ce diagnostic est plus précis qu’ajouter des ressources au serveur sans preuve. Il permet aussi de distinguer le ralentissement initial de la charge supplémentaire provoquée par les reprises.
Comprendre le rôle d’OpenTelemetry
OpenTelemetry fournit des mécanismes et des conventions pour instrumenter les applications et exporter des signaux. Il ne constitue pas à lui seul une interface complète de stockage et d’analyse. Les données doivent être envoyées vers des systèmes capables de les conserver et de les explorer. Selon le contexte, une instrumentation automatique peut fournir une première visibilité, complétée par des spans métier. Utilisez des noms et attributs cohérents pour éviter des interprétations différentes entre services. Le choix des signaux doit être guidé par les questions de diagnostic et non par la simple capacité à collecter davantage.
Échantillonner et maîtriser les volumes
Conserver toutes les traces de toutes les requêtes peut coûter cher. L’échantillonnage permet de sélectionner une partie des données, mais peut aussi masquer des cas rares s’il est mal choisi. Définissez ce que vous voulez préserver : erreurs, parcours critiques ou opérations lentes selon les capacités du système. Les logs trop bavards et les étiquettes de métriques trop nombreuses augmentent également la facture. Mesurez le volume et la valeur diagnostique. Une stratégie raisonnable collecte assez pour comprendre les incidents sans recopier indéfiniment tout ce qui traverse l’application.
Créer des alertes auxquelles quelqu’un peut répondre
Une bonne alerte correspond à un impact ou à un risque nécessitant une action. Indiquez le service concerné, les symptômes, le propriétaire et un lien vers les éléments de diagnostic. Des alertes trop fréquentes et sans action claire créent de la fatigue et finissent ignorées. Utilisez des fenêtres et des seuils adaptés au comportement normal. Un bref pic n’exige pas toujours la même réaction qu’une dégradation durable. Préparez une procédure de réponse et revoyez les alertes après les incidents pour supprimer le bruit et améliorer la capacité de détection.
Déployer une observabilité utile au quotidien
Commencez par un parcours important et reliez métriques, logs et traces grâce à des identifiants cohérents. Faites un exercice de diagnostic sur une erreur simulée pour vérifier que les équipes trouvent les bonnes informations. Contrôlez les accès, la conservation et les coûts. Tuplify Studio peut ajouter instrumentation, journaux structurés et suivi des performances à vos applications et API. L’objectif est de réduire le temps nécessaire pour comprendre une dégradation et agir, pas de remplir un mur de graphiques. Les signaux ne créent de valeur que lorsqu’ils répondent à des questions concrètes d’exploitation.
Atelier : retrouver une requête lente de bout en bout
Dans un environnement de test, ralentissez une dépendance utilisée par un parcours connu. Lancez une requête et recherchez son identifiant dans les logs, puis sa trace et les métriques du service. Vérifiez si vous pouvez identifier l’étape lente sans ajouter de nouvelle instrumentation. Assurez-vous que les durées utilisent les mêmes unités et que le contexte traverse les appels. Faites ensuite échouer cette dépendance et observez les nouvelles tentatives. Cet exercice montre si les signaux permettent réellement un diagnostic ou s’ils ne produisent que des graphiques isolés. Il permet aussi de vérifier que les journaux restent utiles sans exposer les secrets ou les contenus sensibles de la requête.
Questions fréquentes : outils et alertes
OpenTelemetry stocke-t-il toutes les données ? Il fournit notamment instrumentation et export ; le stockage et l’exploration reposent sur des composants ou services adaptés.
Faut-il conserver toutes les traces ? Cela dépend des besoins et des coûts. Une stratégie de sélection doit préserver suffisamment de cas utiles, en tenant compte des erreurs rares.
Une alerte sur chaque erreur améliore-t-elle la fiabilité ? Elle peut surtout créer du bruit. Définissez un impact, une fenêtre et une action attendue. Les alertes doivent aider une personne à intervenir. Revoyez celles qui ne conduisent jamais à une décision et complétez celles qui n’ont pas détecté une dégradation importante réellement vécue par les utilisateurs.
Ce que nous pouvons développer pour vous
Nous ajoutons supervision, logs structurés et traçage pour diagnostiquer les problèmes de production.
Parlons de votre projetPour aller plus loin · documentation officielle
OpenTelemetry — ObservabilityTuplify Studio · Guides pédagogiques créés avec l’aide de l’IA. Les exemples sont illustratifs.