Évaluer un assistant IA : qualité, coût et latence expliqués
Créez un processus d'évaluation pratique pour votre fonctionnalité d'IA en utilisant des cas représentatifs, des critères humains et des retours de production.
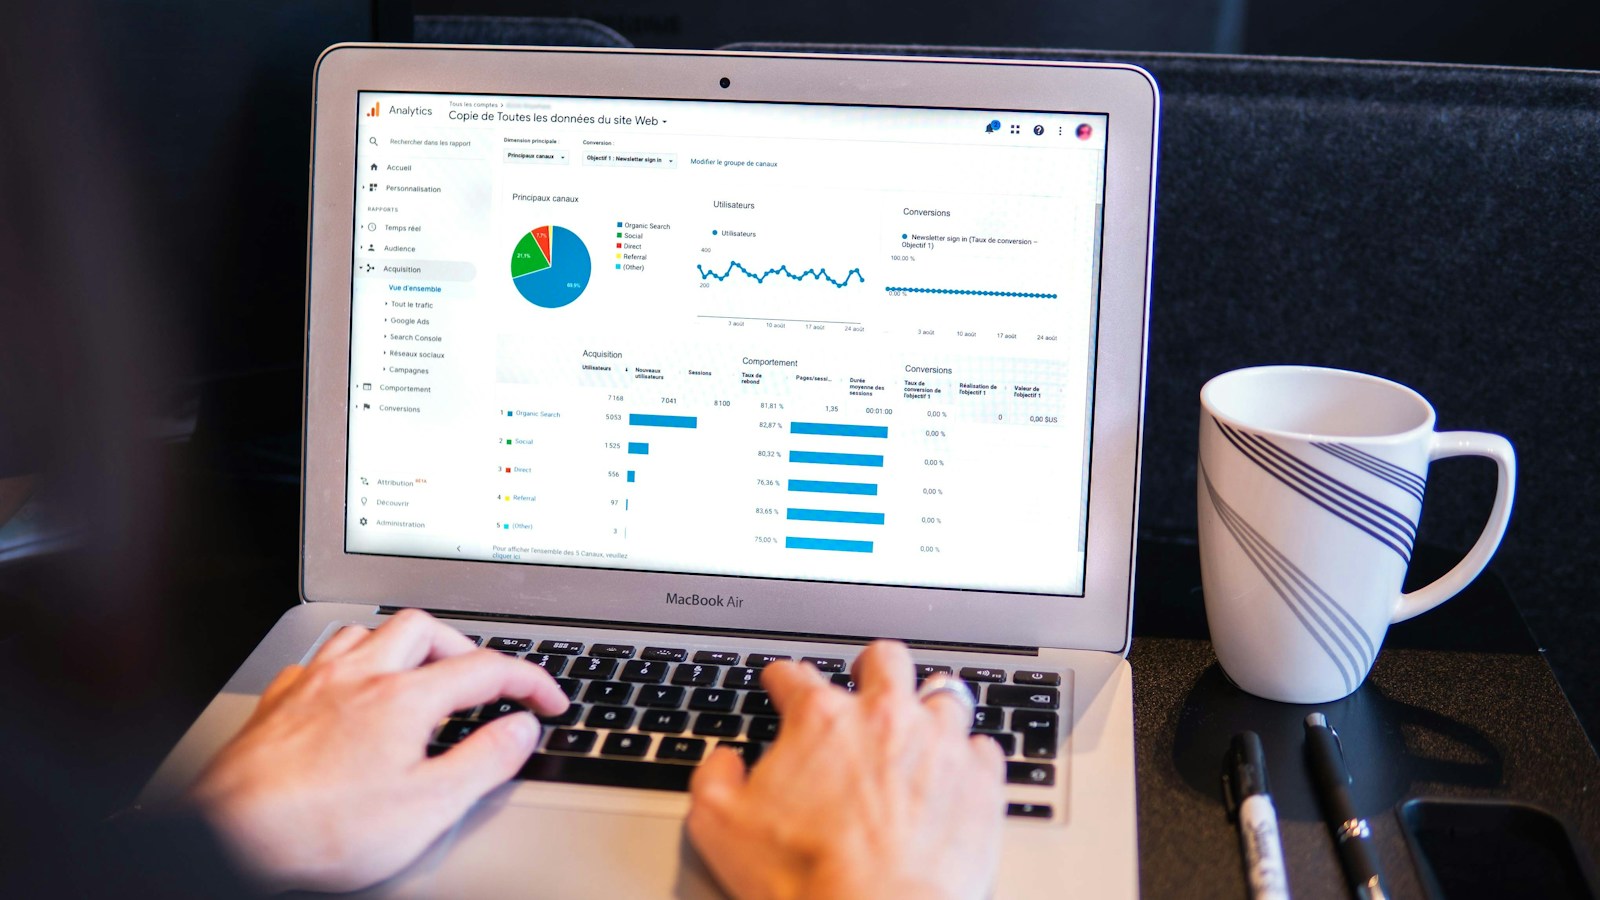
Un écran affichant des analyses, illustrant la mesure de la qualité et des performances du logiciel.
Définir ce que le succès signifie pour l'utilisateur
Un assistant IA peut sembler utile sans accomplir la tâche demandée. L'évaluation commence par un résultat observable : une réponse correcte avec une source pertinente, un résumé précis ou un brouillon correctement préparé. Écrivez les critères d'acceptation avec les personnes qui effectuent ce travail. Distinguer l'exactitude factuelle, l'exhaustivité, le ton et la sécurité opérationnelle. Un résumé qui omet une condition d’annulation peut être plus préjudiciable qu’un résumé contenant une phrase maladroite. Évitez de regrouper toutes les préoccupations en un vague score de qualité avant de comprendre les types d’erreurs qui comptent pour l’entreprise.
Construire un ensemble de référence représentatif
Rassemblez des exemples anonymisés des flux de travail que vous souhaitez prendre en charge. Incluez les demandes courantes, les exceptions difficiles, les messages incomplets et les entrées hors de portée de l'assistant. Gardez la diversité linguistique et documentaire proche de la réalité. Enregistrez les preuves attendues et les résultats acceptables plutôt que d’exiger une formulation exacte pour chaque réponse. Séparez les cas de développement des cas réservés à l’évaluation. Si l'équipe modifie à plusieurs reprises les invites en fonction de la même poignée d'exemples, l'amélioration peut refléter une familiarité avec ces exemples plutôt qu'un produit plus fiable. Conservez la collection à mesure que les flux de travail pris en charge changent.
Utiliser différentes vérifications pour différentes propriétés
Les contrôles déterministes fonctionnent bien pour les formats, les champs obligatoires, les actions autorisées et les calculs exacts. Le jugement humain est souvent utile pour déterminer si un résumé préserve le sens important. Les systèmes de récupération doivent vérifier les passages trouvés avant de juger de la réponse finale. Un assistant qui prend des mesures doit inspecter les appels d’outils et l’état qui en résulte. Choisissez la méthode de test en fonction de la propriété évaluée. Une réponse contenant une URL source n’a pas nécessairement cité la bonne source. Un appel d'outil bien formulé peut toujours être non autorisé ou cibler le mauvais client.
Rédigez une grille de notation que les gens peuvent appliquer
Définissez un petit ensemble de niveaux compréhensibles pour chaque dimension importante. Pour un support factuel, distinguez les réponses entièrement étayées, partiellement non étayées et matériellement incorrectes. Donnez aux évaluateurs des exemples et un moyen de signaler l’incertitude. Comparez les jugements des évaluateurs et enquêtez sur les désaccords plutôt que de les traiter comme du bruit. Une rubrique doit expliquer ce qui entraîne une erreur. Elle ne devrait pas accorder la même pénalité à une préférence stylistique et à la divulgation d'un document à diffusion restreinte. Gardez le processus d’examen suffisamment court pour que les experts du domaine puissent l’utiliser régulièrement.
Exemple : évaluer une fonctionnalité de résumé de support
L'assistant résume un ticket avant qu'un nouvel agent prenne le relais. Vérifiez s'il préserve le symptôme signalé, les actions déjà entreprises, les questions non résolues et les engagements des clients. Comparez le résumé avec les messages d'origine, et non avec un résumé généré par un autre modèle seul. Mesurez le temps nécessaire pour corriger et acceptez-le. Incluez des tickets contenant des informations contradictoires et des messages dans plusieurs langues. Enregistrez si la fonctionnalité a réduit l’effort de transfert sans cacher les faits essentiels. Ces observations fournissent une mesure de réussite plus utile que de demander aux évaluateurs s'ils ont généralement apprécié l'assistant.
Comprendre les limites de la notation basée sur un modèle
Un modèle de langue seconde peut aider à filtrer de grands ensembles d'évaluation, mais il peut partager des biais ou des erreurs avec le modèle testé. Il peut préférer une réponse plus longue, manquer une erreur factuelle ou suivre des instructions intégrées dans une réponse évaluée. Calibrez-le par rapport aux jugements humains et utilisez des critères explicites. Gardez les réponses sous-jacentes disponibles pour inspection. Considérez les scores automatisés comme des mesures avec des limites, et non comme une preuve d'exactitude. Pour les limites d’autorisation et les transactions commerciales, inspectez les résultats déterministes. L'opinion favorable d'un évaluateur ne peut pas autoriser une action ou annuler une lecture non autorisée.
Comparez les versions dans des conditions contrôlées
Enregistrez le modèle, l'invite, les paramètres de récupération et la version des données pour chaque exécution. Comparez les versions sur les mêmes cas et notez le caractère aléatoire pertinent. Certaines tâches nécessitent des essais répétés pour comprendre les variations. Évitez de modifier plusieurs composants simultanément lorsque vous devez identifier la raison pour laquelle les résultats ont évolué. Signalez les catégories et la répartition des erreurs, pas seulement un score moyen. Une version qui améliore de nombreux cas simples mais échoue dans un flux de travail critique peut être inacceptable. Conservez les résultats de référence et les décisions des réviseurs afin que l’équipe puisse expliquer pourquoi un changement a été promu ou rejeté.
Mesurer le coût par résultat accepté
Incluez les appels de modèle, la récupération, les tentatives et le temps passé par le réviseur. Une réponse peu coûteuse qui nécessite une régénération répétée peut coûter plus cher qu’une première tentative plus performante. Suivez la taille du contexte et la longueur de la sortie, et mesurez si des informations supplémentaires améliorent réellement la qualité. Répartissez les coûts par catégorie de tâches plutôt que de les répartir sur l’ensemble du trafic. Une demande d’analyse de document et une demande de classification brève nécessitent des budgets différents. Fixez des limites et définissez ce qui se passe lorsqu’elles sont atteintes. Les contrôles des coûts devraient produire une solution de repli compréhensible plutôt que de laisser tomber silencieusement des informations ou de présenter une tâche incomplète comme terminée.
Mesurer la réactivité en tant qu'expérience utilisateur
Distinguer le temps jusqu'à la première réponse visible du temps jusqu'à un résultat complet et utilisable. Le streaming peut rendre une interface réactive tandis que la décision importante reste retardée. Mesurez les cas de lenteur ainsi que les moyennes et testez des conditions de réseau réalistes. Les appels d’outils, les étapes de recherche et de révision contribuent à la durée totale. Établissez un délai d'attente et un chemin de récupération qui préserve le travail de l'utilisateur. Une fonctionnalité précise mais qui interrompt régulièrement un flux de travail d'assistance chargé peut ne pas être utile. Évaluez si l’application communique clairement les progrès et les échecs, et pas seulement si le fournisseur finit par revenir.
Connectez les tests hors ligne avec les retours de production
Les tests de référence détectent les régressions connues, tandis que l'utilisation réelle révèle de nouvelles questions et modifications des données. Collectez les corrections explicites et les résultats des tâches avec des règles d'accès et de conservation appropriées. Ne présumez pas que chaque réponse acceptée a été soigneusement vérifiée ou que chaque session abandonnée était un échec du modèle. Échantillonnez des cas de production pour examen et ajoutez de nouveaux modèles de défaillance significatifs à l’ensemble de référence. Surveillez la dérive dans la fraîcheur de la récupération, les langues et les types de demandes. La qualité d'une fonctionnalité peut diminuer sans déploiement de code lorsque les documents sources changent ou que les utilisateurs commencent à poser des questions en dehors de la portée initialement testée.
Atelier : préparer une décision de mise en liberté
Choisissez une amélioration candidate et évaluez-la par rapport à la version actuelle sur une collection fixe. Définir les critères d’acceptation avant d’inspecter les résultats. Examinez les défaillances critiques individuellement et comparez le temps, le coût et la latence de correction. Ajoutez quelques cas inconnus pour vérifier si l’amélioration se généralise. Rédigez une courte décision expliquant les avantages, les régressions et les limites restantes. Exécutez la même évaluation après avoir modifié le fournisseur de modèle ou les paramètres de récupération. Cet atelier crée une pratique de publication reproductible et évite de promouvoir une version car une démonstration a semblé impressionnante lors d'une réunion.
Questions fréquemment posées
Existe-t-il un score de qualité universel pour l’IA ? Non. Les critères utiles dépendent de la tâche et des conséquences.
La satisfaction des utilisateurs peut-elle remplacer l’examen factuel ? Il fournit des commentaires précieux, mais une erreur convaincante peut satisfaire un lecteur qui ne dispose pas des informations sources.
La réussite de l’ensemble de référence garantit-elle une fiabilité future ? Il montre les performances sur ces cas dans les conditions testées. Les nouvelles demandes et les modifications de données doivent encore être surveillées.
Comment Tuplify Studio peut-il vous aider ? Nous pouvons connecter des ensembles de données d’évaluation, des interfaces d’examen et des métriques de production à votre application d’IA. Le résultat devrait être un processus décisionnel fondé sur des preuves que votre équipe comprend, plutôt qu'un tableau de bord rempli de scores dont personne ne peut expliquer la signification.
Ce que nous pouvons développer pour vous
Tuplify Studio développe des workflows d'évaluation et de suivi de l'IA autour de vos assistants, de la recherche de documents et de l'automatisation du CRM.
Parlons de votre projetPour aller plus loin · documentation officielle
Google Cloud — Generative AI evaluationTuplify Studio · Guides pédagogiques créés avec l’aide de l’IA. Les exemples sont illustratifs.